介绍
将维表数据存储在Redis、HBase、MySQL等外部存储系统中,Flink接收到一个数据,就实时去外部存储中查询
优点
维度数据量不受内存限制,可以存储很大的数据量。
缺点
同步方式影响性能:Flink 查询外部存储系统(MySQL、redis、Hbase)时,是同步方式:
- 先执行一次查询,等待外部系统返回数据
- 再发送第二个请求
时间耗费在网络传输上
解决
使用异步IO
查询到的结果缓存起来
例子-使用异步IO
Flink中可以使用异步IO来读写外部系统,使用AsyncDataStream和AsyncFunction、RichAsyncFunction 进行异步处理
注意:要求外部系统客户端支持异步IO,否则需要 自定义实现异步IO
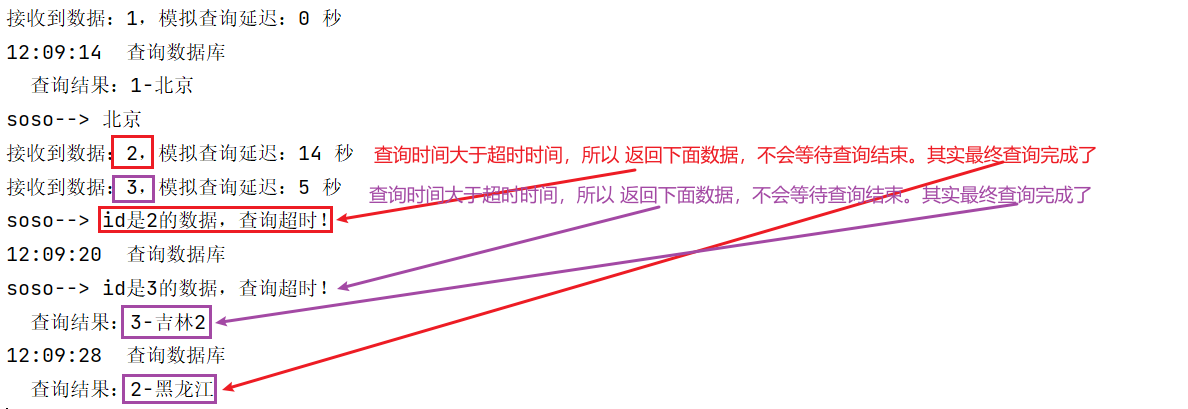
使用异步就要涉及到三个问题:
- 超时:如果查询超时那么就认为是读写失败,需要按失败处理;
- 并发数量:如果并发数量太多,就要触发Flink的反压机制来抑制上游的写入。
- 返回顺序错乱:顺序错乱了要根据实际情况来处理,Flink支持两种方式:允许乱序、保证顺序。
建表
CREATE TABLE `t_city` (
    `cid` INT(11) NOT NULL,
    `cname` VARCHAR(64) NOT NULL COLLATE 'utf8mb4_general_ci',
    PRIMARY KEY (`cid`)
)
ENGINE=InnoDB
;
添加测试数据
INSERT INTO `t_city` (`cid`, `cname`) VALUES (1, '北京');
INSERT INTO `t_city` (`cid`, `cname`) VALUES (2, '黑龙江');
INSERT INTO `t_city` (`cid`, `cname`) VALUES (3, '吉林2');
pom.xml 依赖
<properties>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    <maven.compiler.source>1.8</maven.compiler.source>
    <maven.compiler.target>1.8</maven.compiler.target>
    <flink.version>1.12.0</flink.version>
</properties>

<dependencies>
    <!--java-->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-java</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-streaming-java_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-clients_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-api</artifactId>
        <version>1.7.30</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-log4j12</artifactId>
        <version>1.7.30</version>
    </dependency>
    <dependency>
        <groupId>log4j</groupId>
        <artifactId>log4j</artifactId>
        <version>1.2.17</version>
    </dependency>
    <dependency>
        <groupId>mysql</groupId>
        <artifactId>mysql-connector-java</artifactId>
        <version>5.1.47</version>
    </dependency>
    <!-- kafka Dependency -->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-connector-kafka_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
</dependencies>
java代码
package flink;

import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.configuration.Configuration;
import org.apache.flink.streaming.api.datastream.AsyncDataStream;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.async.ResultFuture;
import org.apache.flink.streaming.api.functions.async.RichAsyncFunction;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.kafka.clients.consumer.ConsumerConfig;

import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.ResultSet;
import java.text.SimpleDateFormat;
import java.util.*;
import java.util.concurrent.*;

public class 异步IO {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 定义kafka相关配置项
        Properties pro = new Properties();
        pro.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        pro.setProperty(ConsumerConfig.GROUP_ID_CONFIG,"consumer-group");
        pro.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG,"latest");
        // 内置连接器,创建FlinkKafka消费者,需要指定主题、反序列化、kafka配置
        FlinkKafkaConsumer<String> fkc = new FlinkKafkaConsumer<>("kafka2flink", new SimpleStringSchema(), pro);
        DataStreamSource<String> dss = env.addSource(fkc);

        SingleOutputStreamOperator<String> soso = AsyncDataStream.orderedWait(
                dss,
                new MyRichAsyncFunction() ,
                5,
                TimeUnit.SECONDS);

        soso.print("soso--");
        env.execute();
    }
    static class MyRichAsyncFunction extends RichAsyncFunction<String,String> {
        // MySQL数据库连接
        static final String URL = "jdbc:mysql://localhost:3308/test?characterEncoding=UTF-8";
        // 数据库用户名
        static final String USERNAME = "root";
        // 数据库密码
        static final String PASSWORD = "";
        // 驱动
        static final String DRIVER = "com.mysql.jdbc.Driver";

        //数据库连接
        private Connection conn;
        // 创建线程池
        private ThreadPoolExecutor threadPoolExecutor;
        @Override
        public void open(Configuration parameters) throws Exception {
            Class.forName(DRIVER);
            conn = DriverManager.getConnection(URL, USERNAME, PASSWORD);
            //初始化线程池
            threadPoolExecutor =  new ThreadPoolExecutor(
                    10,
                    10,
                    0,
                    TimeUnit.SECONDS,
                    new ArrayBlockingQueue(1000));
        }
        /**
         * 每来一条数据,就执行一次该方法
         * @param id 输入数据
         * @param resultFuture 通过该对象收集数据
         * @throws Exception
         */
        @Override
        public void asyncInvoke(String id, ResultFuture<String> resultFuture) throws Exception {
            threadPoolExecutor.submit(new Runnable() {
                @Override
                public void run() {
                    try {
                        String name = query(id); // 查询数据库
                        // 通过下面方法收集数据
                        resultFuture.complete(Collections.singleton(name));
                    } catch (Exception e) {
                        e.printStackTrace();
                    }
                }
            });
        }
        // 查询MySQL数据库,并将数据放入到 Map 中
        public String query(String id) throws Exception {
            System.out.print("接收到数据:"+id+",");
            // 模拟查询延迟,单位:秒
            int delay = new Random().nextInt(20);
            System.out.println(String.format("模拟查询延迟:%s 秒", delay));
            Thread.sleep(delay * 1000);

            SimpleDateFormat sdf = new SimpleDateFormat("HH:mm:ss");
            System.out.println(sdf.format(new Date())+"  查询数据库");
            String sql = "select cname from t_city where cid = ?";
            PreparedStatement statement = null;
            ResultSet rs = null;
            String name = null;
            try {
                statement = conn.prepareStatement(sql);
                statement.setString(1,id);
                rs = statement.executeQuery();
                //全量更新维度数据到内存
                if (rs.next()) {
                    name = rs.getString(1);
                    System.out.println(String.format("  查询结果:%s-%s", id, name));
                }
            }finally {
                if(rs!=null) {
                    rs.close();
                }
                if(statement!=null) {
                    statement.close();
                }
            }
            return name;
        }

        /**
         * 如果执行超时,就执行该方法
         * @param id element coming from an upstream task
         * @param resultFuture to be completed with the result data
         * @throws Exception
         */
        @Override
        public void timeout(String id, ResultFuture<String> resultFuture) throws Exception {
            resultFuture.complete(Collections.singleton(String.format("id是%s的数据,查询超时!", id)));
        }

        @Override
        public void close() throws Exception {
            // 关闭数据库连接
            if(conn!=null) {
                conn.close();
            }
            // 终止定时任务
            if(threadPoolExecutor!=null){
                threadPoolExecutor.shutdown();
            }
        }
    }
}
启动zk
登录 hadoop1,执行下面命令:
/program/bin/zk.sh start
启动kafka
登录 hadoop1,执行下面命令:
/program/bin/kafka.sh start
启动 flink
在 idea 中运行 flink 程序
启动生产者、指定主题
登录 hadoop1,执行下面命令:
/program/kafka_2.12-2.4.1/bin/kafka-console-producer.sh --broker-list hadoop1:9092,hadoop2:9092,hadoop3:9092 --topic kafka2flink
然后输入:
1
2
3
执行结果
在 idea 控制台中打印结果如下:
参考:
https://blog.csdn.net/Yuan_CSDF/article/details/117486259