介绍
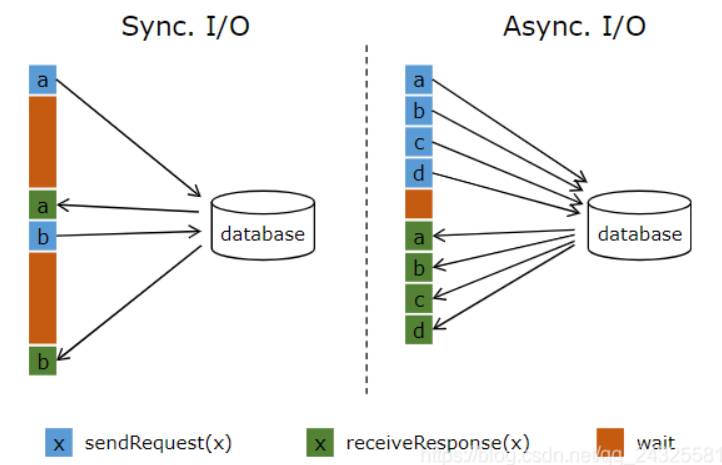
Hbase的原生java 客户端是同步的,在 Flink 中使用原生 API 对hbase 进行增删改查时,前一个数据,可能会发生IO阻塞,等待请求返回,这种同步交互的方式往往在网络等待上就耗费了大量时间。
前一个数据处理后,然后再处理下一个数据,性能低下
asynchbase(Asynchronous HBase)是完全异步,非阻塞的,线程安全的,高性能的 HBase 客户端库
官方网址
https://github.com/OpenTSDB/asynchbase
个人建议
不建议使用,原因如下:
- 该库很久没有更新,可能不支持hbase最新版api
- 该库的api与官方区别很大,需要重新掌握一套api,增加学习难度
例子
pom.xml依赖
<properties>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    <maven.compiler.source>1.8</maven.compiler.source>
    <maven.compiler.target>1.8</maven.compiler.target>
    <flink.version>1.12.0</flink.version>
</properties>

<dependencies>
    <!--java-->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-java</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-streaming-java_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-clients_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-api</artifactId>
        <version>1.7.30</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-log4j12</artifactId>
        <version>1.7.30</version>
    </dependency>
    <dependency>
        <groupId>log4j</groupId>
        <artifactId>log4j</artifactId>
        <version>1.2.17</version>
    </dependency>
    <!-- kafka Dependency -->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-connector-kafka_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.hbase</groupId>
        <artifactId>asynchbase</artifactId>
        <version>1.8.2</version>
        <exclusions>
            <exclusion>
                <groupId>org.slf4j</groupId>
                <artifactId>log4j-over-slf4j</artifactId>
            </exclusion>
            <exclusion>
                <groupId>org.slf4j</groupId>
                <artifactId>slf4j-log4j12</artifactId>
            </exclusion>
        </exclusions>
    </dependency>
</dependencies>
java
package flink;

import com.stumbleupon.async.Callback;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.configuration.Configuration;
import org.apache.flink.streaming.api.datastream.AsyncDataStream;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.async.ResultFuture;
import org.apache.flink.streaming.api.functions.async.RichAsyncFunction;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.hbase.async.GetRequest;
import org.hbase.async.HBaseClient;
import org.hbase.async.KeyValue;

import java.util.*;
import java.util.concurrent.TimeUnit;

public class 异步IO关联查询hbase {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 定义kafka相关配置项
        Properties pro = new Properties();
        pro.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        pro.setProperty(ConsumerConfig.GROUP_ID_CONFIG,"consumer-group");
        pro.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG,"latest");
        // 内置连接器,创建FlinkKafka消费者,需要指定主题、反序列化、kafka配置
        FlinkKafkaConsumer<String> fkc = new FlinkKafkaConsumer<>("kafka2flink", new SimpleStringSchema(), pro);
        DataStreamSource<String> dss = env.addSource(fkc);
        dss.print("dss:");
        SingleOutputStreamOperator soso = AsyncDataStream.orderedWait(
                dss,
                new MyRichAsyncFunction(),
                30,
                TimeUnit.SECONDS
        );

        soso.print("soso--");
        env.execute();
    }
    public static class MyRichAsyncFunction extends RichAsyncFunction<String,String> {

        static final String TABLE = "book";
        private HBaseClient client = null;
        @Override
        public void open(Configuration parameters) throws Exception {
            super.open(parameters);
            //创建hbase客户端
            client = new HBaseClient("hadoop1,hadoop2,hadoop3","/hbase");
        }

        @Override
        public void asyncInvoke(String input, ResultFuture<String> resultFuture) throws Exception {

            //从hbase获取维度数据
            client.get(new GetRequest(TABLE, input)).addCallback(
                    new MyCallback(resultFuture)
            );

        }

    }

    static class MyCallback implements Callback<Object, ArrayList<KeyValue>> {

        private ResultFuture<String> resultFuture;

        public MyCallback(ResultFuture<String> resultFuture) {
            this.resultFuture = resultFuture;
        }

        @Override
        public Object call(ArrayList<KeyValue> input) throws Exception {
            String data = "";
            for (KeyValue keyValue : input ){
                String key = new String(keyValue.key());
                String value = new String(keyValue.value());
                String family = new String(keyValue.family());
                String qualifier = new String(keyValue.qualifier());
                String temp = key+","+family+","+qualifier+","+value;
                data = data+temp+";;;";
            }
            System.out.println(data);
            resultFuture.complete(Collections.singleton(data));
            return null;
        }
    }

}
启动zk
登录 hadoop1,执行下面命令:
/program/bin/zk.sh start
启动hadoop
登录 hadoop1,执行下面命令:
/program/bin/hadoop.sh start
启动hbase
登录 hadoop1,执行下面命令:
start-hbase.sh
建表
create "book","c1"
添加测试数据
put 'book','1020','c1:author','韩梅梅'
put 'book','1020','c1:price','121.90'
put 'book','1020','c1:title','scala从入门到精通'
启动kafka
登录 hadoop1,执行下面命令:
/program/bin/kafka.sh start
启动 flink
在 idea 中运行 flink 程序
启动生产者、指定主题
登录 hadoop1,执行下面命令:
/program/kafka_2.12-2.4.1/bin/kafka-console-producer.sh --broker-list hadoop1:9092,hadoop2:9092,hadoop3:9092 --topic kafka2flink
然后输入:
1020
10211
执行结果
在 idea 控制台中打印结果如下:
dss:> 1020
1020,c1,author,韩梅梅;;;1020,c1,price,121.90;;;1020,c1,title,scala从入门到精通;;;
soso--> 1020,c1,author,韩梅梅;;;1020,c1,price,121.90;;;1020,c1,title,scala从入门到精通;;;
dss:> 10211

soso-->