生产者发消息流程
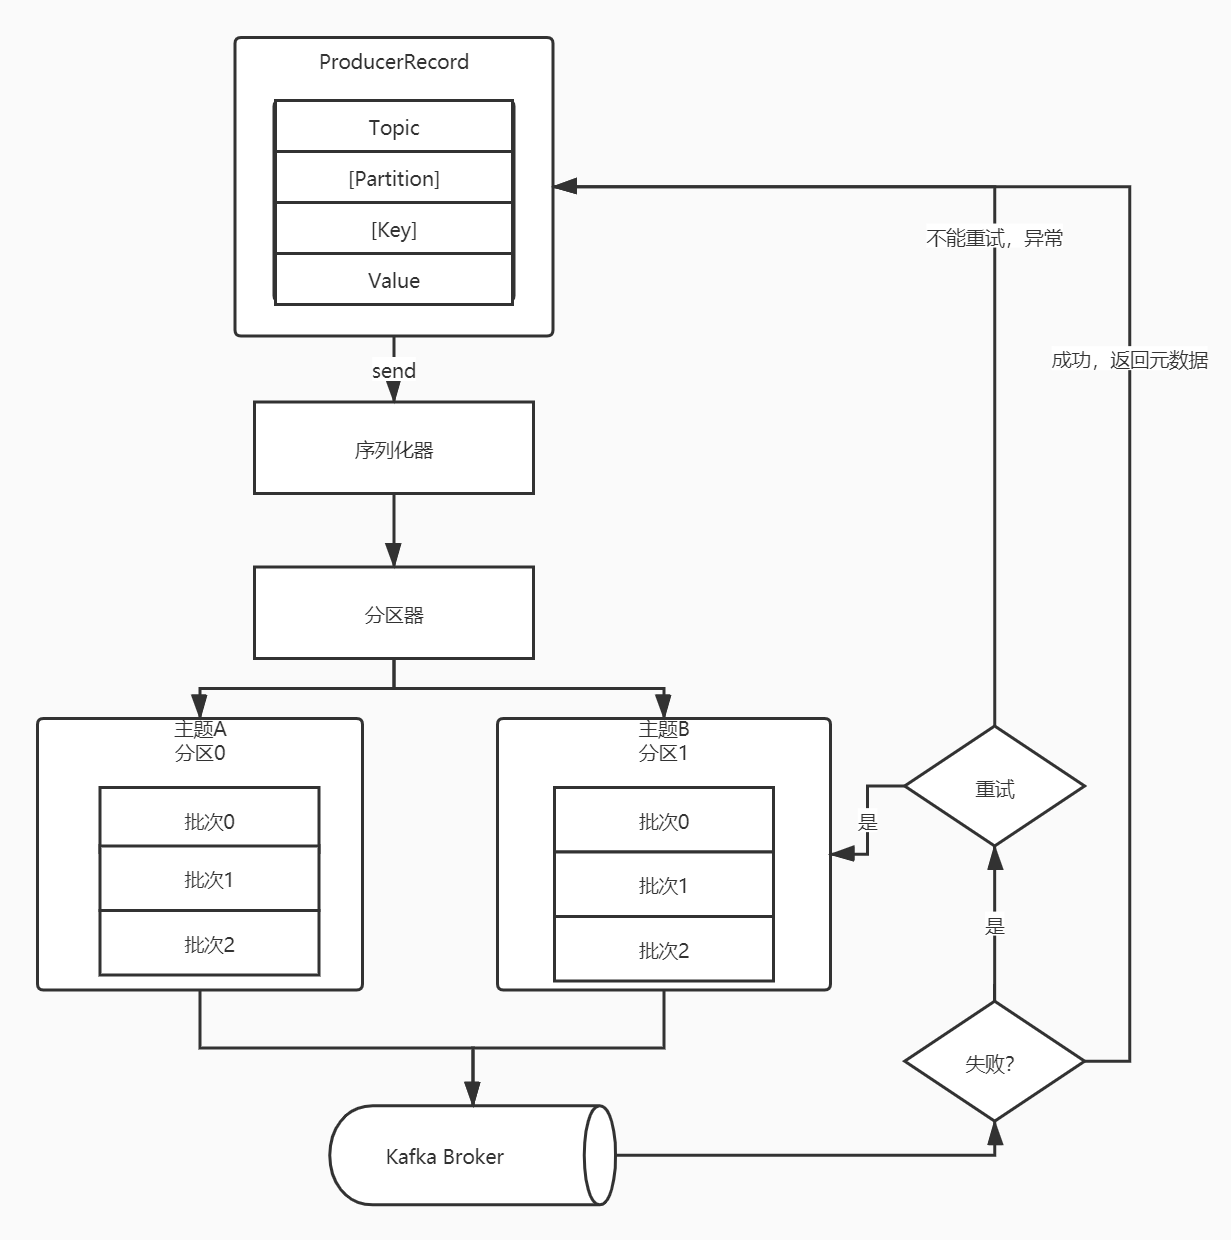
创建一个消息,topic、value必填,key、partition可以选填;
调用
send()方法,根据指定的key.serializer、value.serializer将 key与value进行序列化,将对象序列化为 字节数组,才能在网络上进行传输。如果ProducerRecord指定了分区,分区器不会做任何事情,否则会按照指定的分区策略选择一个分区。
生产者发送消息是按照批次来发,所以消息选择好了分区之后,生产者并不会立即发送消息到服务端,而是消息添加到本地的消息批次里,这个批次的所有消息的topic和分区都相同。
生产者有个 后台Sender线程,负责将消息发送到服务端。服务端在接收到消息之后会返回一个响应,它包含主题和分区信息以及消息在分区中的偏移量。如果消息写入失败会返回一个错误。生产者接收到错误之后会根据配置的retries,尝试重复发送消息,如果超过retries配置的重试次数,还是发送失败,就会返回错误。
序列化机制(序列化与反序列化)
Kafka遵守生产者消费者模式,这中间涉及到 序列化 与 反序列化。
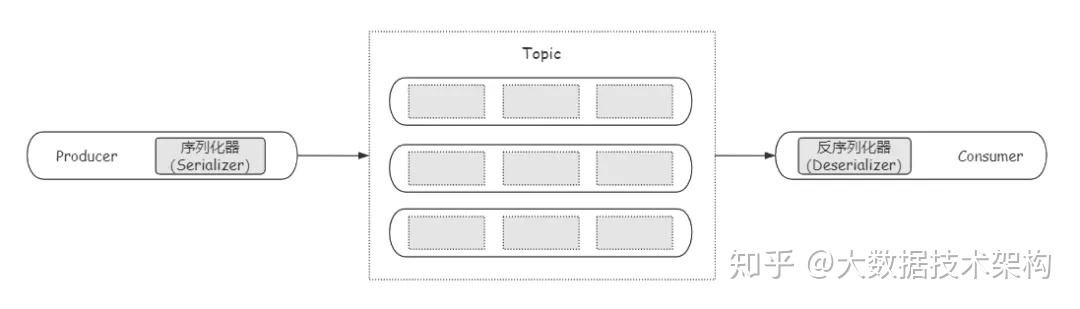
生产者 发送消息要通过 序列化器(Serializer) 将 消息对象 转换成 字节数组,才能通过网络传输到服务端
消费者 需要通过 反序列化器(Deserializer) 从服务端拉取 字节数组 转成 消息对象。
注意: 消费者 和 生产端 的序列化器要 相同,否则将无法解析出想要的数据。
默认序列化器
目前Kafka提供了十几种序列化器,常见的序列化器有:
- StringSerializer // 序列化String类型。
- ByteArraySerializer // 序列化Byte数组,本质上什么都不用做。
- ByteBufferSerializer // 序列化ByteBuffer。
- BytesSerializer // 序列化Kafka自定义的Bytes类。
- LongSerializer // 序列化Long类型。
- IntegerSerializer // 序列化Integer类型。
- ShortSerializer // 序列化Short类型。
- DoubleSerializer // 序列化Double类型。
- FloatSerializer // 序列化Float类型。
除了使用Kafka自带的序列化器,也可以自定义序列化器,只要实现 Kafka Serializer 接口并实现序列化逻辑即可,不过一般自带序列化器已经够用了。
感谢:
https://blog.csdn.net/weixin_39790760/article/details/110801846
Partition 分区
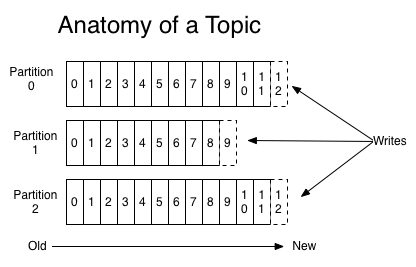
kafka会将一个topic划分成n个分区,在不同的 Kafka Broker,这样可以提高消息吞吐量。每一个消息只能存在于一个分区中,不会重复保存
每个Partition在物理上对应一个 文件夹,该文件夹下存储这个Partition的所有消息
分区策略
生产者会拿到整个集群的信息,所以生产者知道每个topic下面的分区数量等信息
一个消息被发送到指定的 Topic 后,要进入哪个分区,需要根据分区策略来决定
分区策略有:
- 轮询策略
- 哈希策略
- 随机策略
- 自定义策略
轮询策略
在创建消息的时候 不指定 key,会依次将消息发送该topic下的每一个分区,默认策略。
比如:一个 Topic 被分成了 3个分区,那么,第一条消息进入 分区0,第二条消息进入 分区1,第三条消息进去 分区2,第四条消息再进入到 分区0,以此类推
哈希策略
在创建消息时指定 key,kafka将 key 的hash值进行计算,得出分区号,将消息保存到该分区。
提示:这个 key 可以是客户编号、业务 ID、时间戳、交易订单号等等,根据具体业务而定
好处: key相同的消息会在一个分区下。kafka并不能保证全局有序,但是在每个分区下的消息是有序的,按照顺序存储,按照顺序消费。
应用场景:如果你的业务需要多个消息之间保证顺序,那么,可以给他们同样的 key,然后根据 key 来计算分区,这样既可以享受分区带来的高吞吐量,也可以保证消息顺序。
随机策略
消息更平均地分布在各个分区中,但它的效果其实不如轮询策略
自定义策略
实现Partitioner接口就能自定义分区策略。
消息缓冲池
生产者 发送的消息 经过序列化器、分区器处理后,并不是直接发往broker端,而是发送到客户端的 消息缓冲池(Accumulator) 中,最后交由Sender线程发往broker端。
缓冲池最大大小由参数 buffer.memory 控制,默认是 32M,当生产消息的速度过快导致buffer满了的时候,将阻塞 max.block.ms 时间,超时抛异常,所以buffer的大小可以根据实际的业务情况进行适当调整。
批量发送
发送到缓冲池中消息将会被分为一个一个的 batch,分批次的发送到broker 端
批次大小由参数 batch.size 控制,默认 16KB。这就意味着正常情况下消息会攒够 16KB 时才会批量发送到broker端,所以一般 减小batch大小有利于降低消息延时,增加batch大小有利于提升吞吐量。
但是消息并不是必须要达到一个batch尺寸才会批量发送到服务端呢,Producer端提供了另一个重要参数 linger.ms,用来控制batch最大的空闲时间,超过该时间的batch也会被发送到broker端。
参考:
https://www.jianshu.com/p/17ff6eaae4fb
https://blog.csdn.net/weixin_39790760/article/details/110801846
https://juejin.cn/post/7030810678873030664