分块机制
HDFS中的文件在物理上是分块存储(block)的,块的大小可以通过配置参数来规定
通过 hdfs-default.xml 中的 dfs.blocksize 配置。默认大小是128M(134217728)
块大小
2.7.3版本开始默认大小为 128M
之前默认值是 64M
目的
有利于 数据并行处理 和 数据容灾恢复
作用
假设当前为 hadoop 2.7.3版本
把一个 100M 的文件 上传 hdfs 中,文件不会分割,就是100M
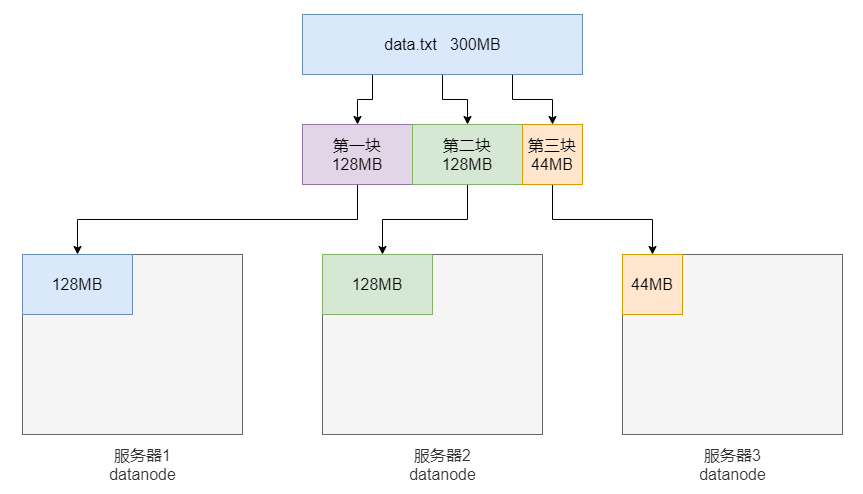
把一个 300M 的文件 上传 hdfs 中,文件会按
128M来分割,共分割 3 块:第一块128M,第二块128M,第三块44M,然后保存到 不同的datanode上
块大小(block size)设置
与磁盘速度有关
磁盘传输速率为 200MB/s 时,一般设定 block大小为 256MB
磁盘传输速率为 400MB/s 时,一般设定 block大小为 512MB
寻址时间
HDFS中找到目标文件block块所花费的时间
block 过大、过小 的问题
block 过大的问题
从磁盘传输数据的时间会明显大于寻址时间,导致程序在处理这块数据时,变得非常慢;
MapReduce中的map任务通常一次只处理一个块中的数据,如果块过大运行速度也会很慢。
block 过小的问题
存放大量小文件会占用NameNode中大量内存来存储元数据,而 NameNode的内存是有限的,不可取;
块过小,寻址时间增长,导致程序一直在找block的开始位置。
总结
块适当设置大一些,减少寻址时间,传输一个有多个块组成的文件的时间主要取决于 磁盘的传输速度
感谢:
https://www.cnblogs.com/sheng-sjk/p/10624958.html