架构
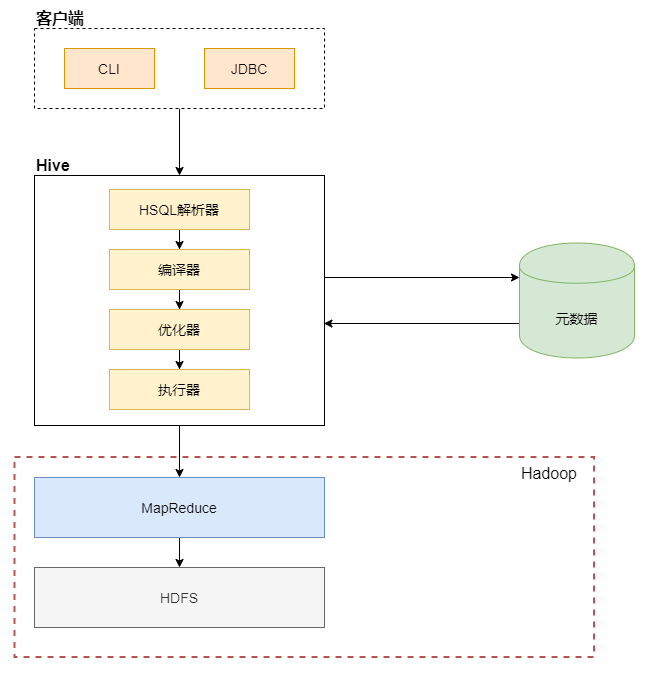
客户端
CLI(command-line interface)、JDBC/ODBC(jdbc 访问 hive)、WEBUI(浏览器访问 hive)
元数据
元数据包括:表名、表所属的数据库(默认是 default)、表的拥有者、列/分区字段、 表的类型(是否是外部表)、表的数据所在目录等;
默认存储在自带的 derby 数据库中
提示:推荐使用 MySQL
Hadoop
使用 HDFS 进行存储,使用 MapReduce 进行计算。
Hive
- 解析器(SQL Parser):将 SQL 字符串转换成 抽象语法树 AST(用 antlr 实现),对 AST 进行语法分析,比如表是否存在、字段是否存在、SQL 语义是否有误。
- 编译器:将 AST 编译生成逻辑执行计划。
- 优化器:对逻辑执行计划进行优化。
- 执行器:把逻辑执行计划转换成可以运行的物理计划。对于 Hive 来 说,就是 MapReduce 或 Spark