介绍
order by 对大数据进行排序时,需要较长时间,一般较少使用
很多时候,并不需要全局排序,可以使用 sort by
注意
当有多个 reducer 时,sort by 只能保证每个reduce的结果有序
即:局部(同一个文件)有序,全局(多个文件)无序
语法
select * from 表名 sort by 列名 [asc/desc]
默认只有 一个 reducer
select ename,deptno from emp sort by deptno desc;
执行结果如下(需要在 hive 环境下运行才能看见):
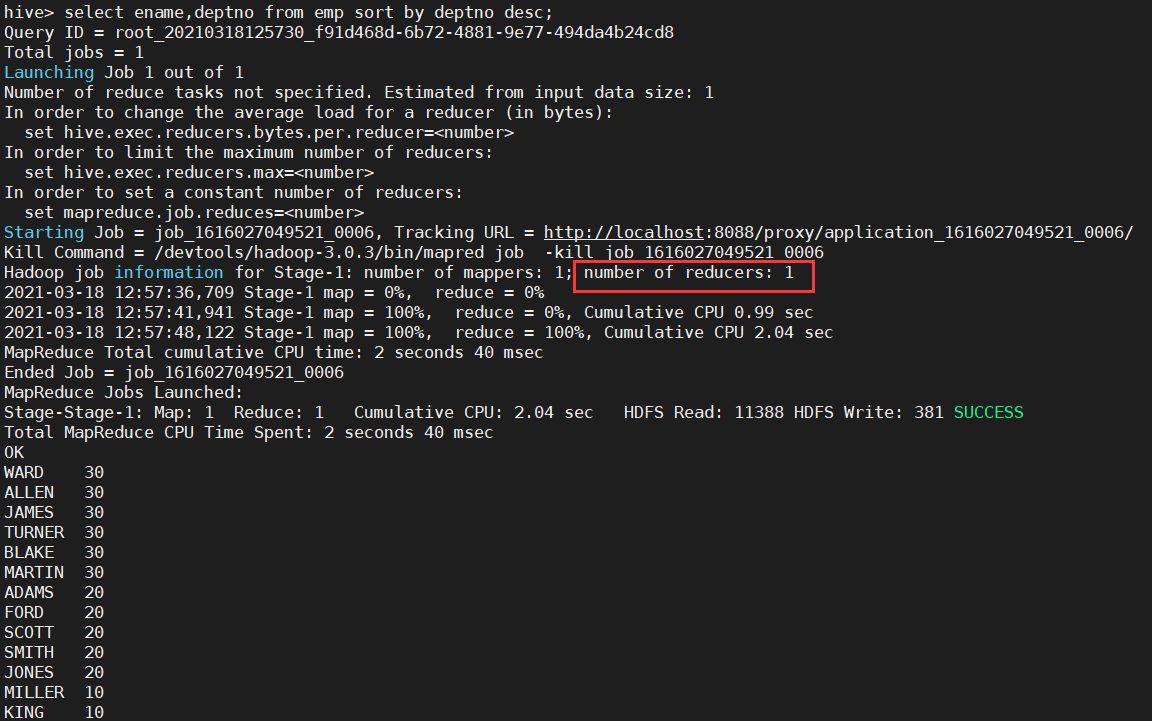
可以看到默认只有 一个 reducer
设置 reduce 数量
在 beeline、dbeaver 环境下执行下面命令:
set mapreduce.job.reduces=2;
查看设置 reduce 数量:
set mapreduce.job.reduces;
使用 sort by 根据 deptno 降序查询:
select ename,deptno from emp sort by deptno desc;
执行结果(需要在 hive 环境下运行才能看见):
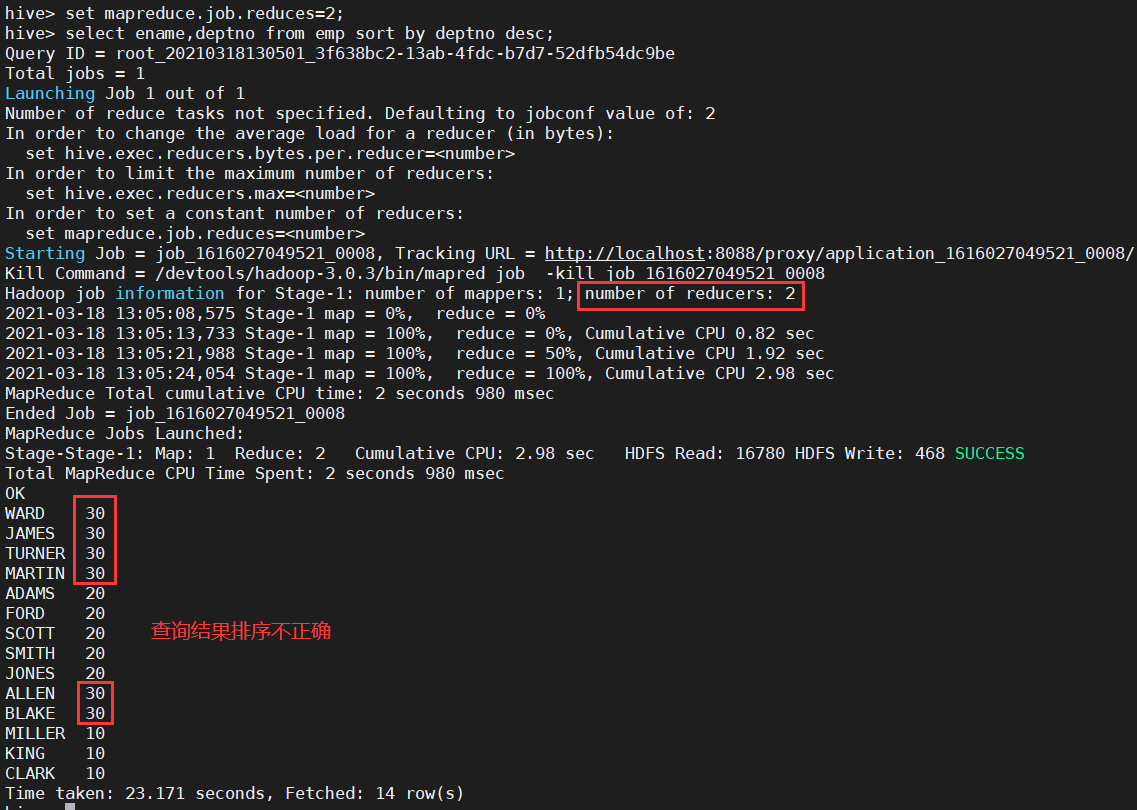
发现查询结果错误
将查询结果导入到文件
insert overwrite local directory '/program/result/'
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
select ename,deptno from emp sort by deptno desc;
执行结果如下:
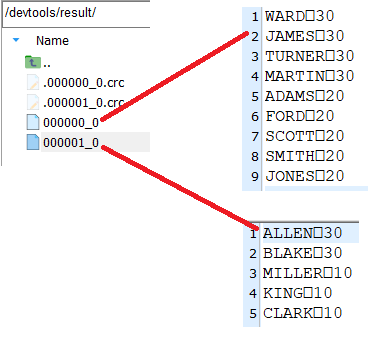
因为是 2个reducer,所以生成 2个文件,每个文件 排序是 对的
2个reducer 是并行的,打印到控制台中,排序是乱的
总结
sort by 局部有序,全局无序