问题描述
一般在 app 中,大量收集用户的行为,如:查看哪些文章、视频、图片等,观看时长,是否点赞,是否评论,收集这些行为数据后,保存到数据库中
假设,该 app 活跃用户有 1000万,每人每天 产生 50条行为数据
每天都要往表中插入 1000万 X 50条 = 5亿 条数据
经过一年的时间,已经有 5亿 x 365天 = 1825亿 条数据
根据 日期 查询数据,HSQL如下:
select * from tbl where date='20200101'
hive会 扫描整个表,从 1825亿 条记录中找出符合条件的,查询速度很慢。
解决
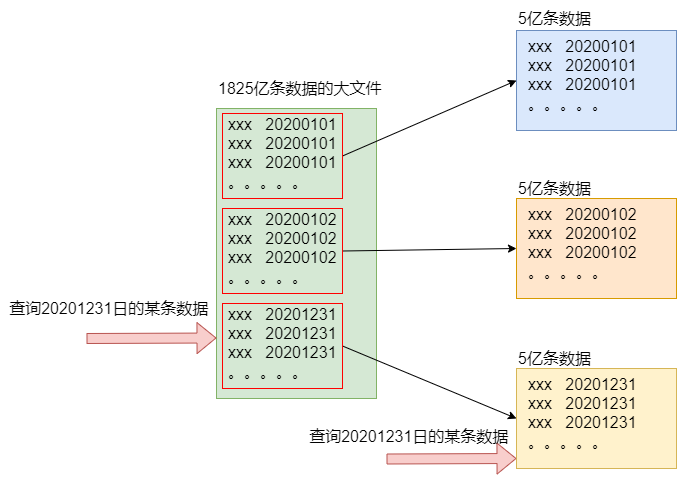
如果使用分区表,以 date 作为分区字段,相同日期的数据在同一个分区,根据 日期 查询数据,直接就定位到该分区, 不扫描整个表,查询速度非常快。
分区表 与 HDFS
分区表 中的 分区,在 HDFS 上是 文件夹
文件夹下的文件,就是该分区的数据
理解:
把一个大的数据集,根据 分区字段 分割成小的数据集,分散在 HDFS 的 文件夹中
在查询时可通过 WHERE 条件查询指定的分区,加快查询速度
分区表的分类
分区表分为:
动态分区表
静态分区表
默认创建的分区表,是 动态分区表
切换
动态分区表与静态分区表相同,可通过 全局开关,设置 动态分区表 和 静态分区表 互相 转换
当 开启动态分区,静态分区表就变成动态分区表。动态分区 区分 严格模式 和 非严格模式
当 关闭动态分区,动态分区表 就变成 静态分区表