介绍
local模式,如果不需要读取 HDFS上的文件,就不需要启动hadoop,只需要一个命令,就可以执行 Spark 环境,一般用于学习,演示等
安装
上传到linux
略
解压缩
tar -zxvf spark-3.0.0-bin-hadoop3.2.tgz
测试启动
cd spark-3.0.0-bin-hadoop3.2
bin/spark-shell
解释:spark交互式窗口,启动后可以直接编写spark程序,在学习、演示中使用
显示如下界面表示成功:
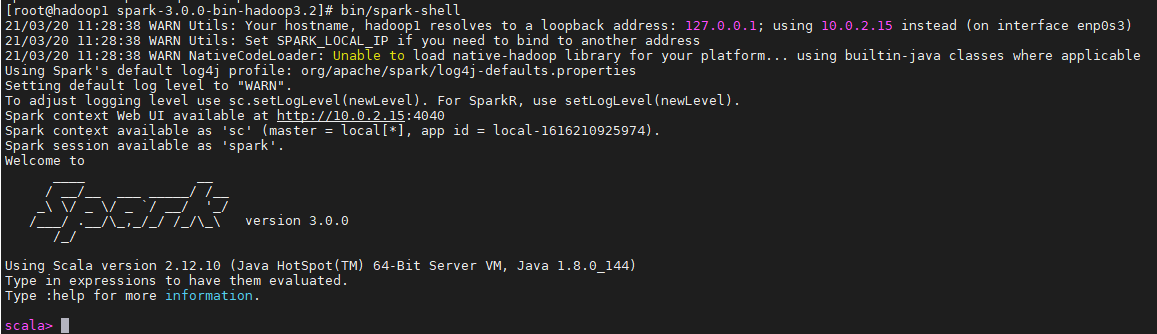
可以在控制台中进行 scala 代码,进行 spark 编程
web页面
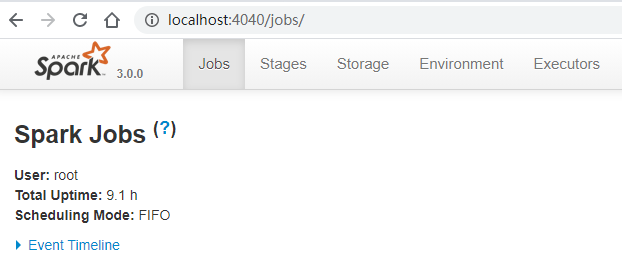
从上面控制台中,可以看到 web页面:http://10.0.2.15:4040
web 页面如下:
执行 wordcount
创建 文本文件
注意: 要保存为 utf-8 编码,否则生成 结果文件是乱码
创建文件 data.txt
vim /devtools/spark_data.txt
内容如下:
李雷
韩梅梅
lucy
lili
张三
李四
王五
李雷
韩梅梅
lucy
李雷
韩梅梅
李雷
执行 scala 代码
代码摘自官网:http://spark.apache.org/examples.html
在控制台窗口中 粘贴 下列代码:
注意:不要随意换行
val textFile = sc.textFile("/devtools/spark_data.txt")

val counts = textFile.flatMap(line => line.split(" ")).map(word => (word, 1)).reduceByKey(_ + _)

counts.saveAsTextFile("/devtools/spark_result")
解释: 读取 /devtools/spark_data.txt 文件,根据空格 ` 统计词出现的次数,并将结果写入到/devtools/spark_result` 目录中
使用 scala 编写 spark 程序,大大简化了代码
web页面
可以查看执行的任务
提交jar应用
在生产环境中,一般用 scala、java实现,并打成 jar 包,然后提交并运行
spark 提供了一些例子,在 /examples/jars/spark-examples_2.12-3.0.0.jar 中,这里演示提交 jar 并运行
cd spark-3.0.0-bin-hadoop3.2/
bin/spark-submit \
--class org.apache.spark.examples.SparkPi \
--master local[2] \
./examples/jars/spark-examples_2.12-3.0.0.jar \
10
解释:
--class表示要执行程序的主类,此处可以更换为咱们自己写的应用程序--master local[2]部署模式,默认为本地模式,数字表示分配的虚拟 CPU 核数量spark-examples_2.12-3.0.0.jar运行的应用类所在的 jar 包,实际使用时,可以设定为自己的 jar 包数字 10表示程序的入口参数,用于设定当前应用的任务数量
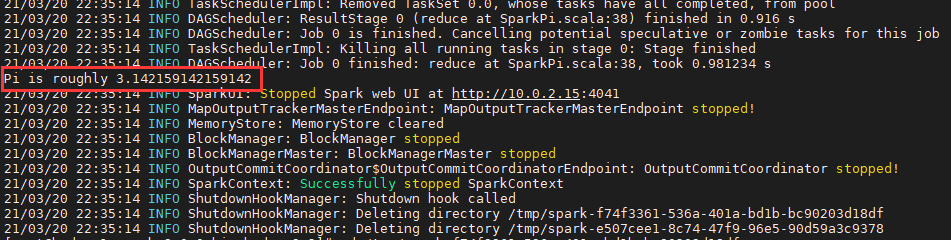
执行结果:
退出
Ctrl+C退出输入 Scala 指令
:quit