idea 安装插件
https://malaoshi.top/show_1IXnyD53SzF.html
创建工程


添加 scala 框架支持


创建scala源码文件夹


标记文件夹为源码

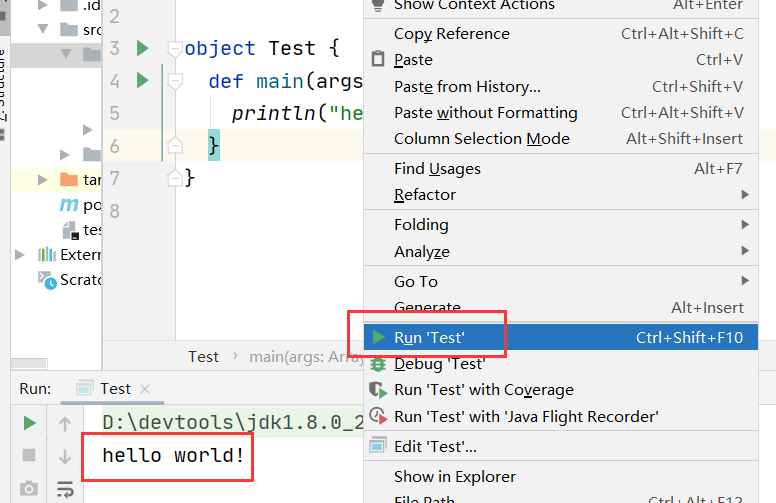
代码
修改pom.xml
<dependencies>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-core_2.12</artifactId>
        <version>3.0.0</version>
    </dependency>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-yarn_2.12</artifactId>
        <version>3.0.0</version>
    </dependency>
</dependencies>


<build>
    <sourceDirectory>src/main/scala</sourceDirectory>
    <plugins>
        <plugin>
            <groupId>net.alchim31.maven</groupId>
            <artifactId>scala-maven-plugin</artifactId>
            <version>3.3.2</version>
            <executions>
                <execution>
                    <goals>
                        <goal>compile</goal>
                        <goal>testCompile</goal>
                    </goals>
                </execution>
            </executions>
        </plugin>
    </plugins>
</build>
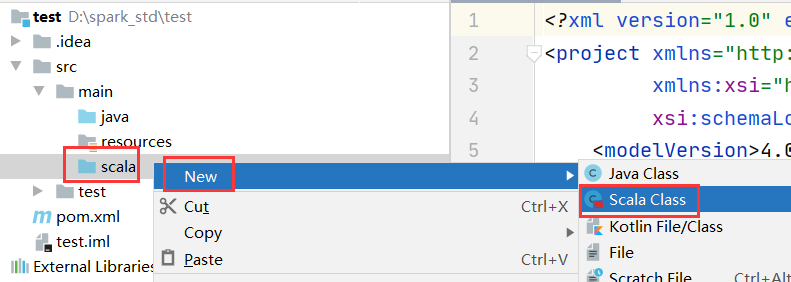
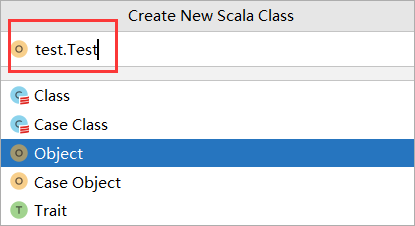
创建scala文件
代码
package test

import org.apache.spark.rdd.RDD
import org.apache.spark.{SparkConf, SparkContext}

object WordCount {
  def main(args: Array[String]): Unit = {

    // 建立和Spark框架的连接
    val sparConf = new SparkConf().setMaster("local").setAppName("WordCount")
    val sc = new SparkContext(sparConf)

    // TODO 执行业务操作

    // 1. 读取文件,获取一行一行的数据
    //    hello world
    val lines: RDD[String] = sc.textFile("data/1.txt")

    // 2. 将一行数据进行拆分,形成一个一个的单词(分词)
    //    扁平化:将整体拆分成个体的操作
    //   "hello world" => hello, world, hello, world
    val words: RDD[String] = lines.flatMap(_.split(" "))

    // 3. 在单词拆分的基础上对每个单词实例计数为1, 也就是 word => (word, 1)
    val pairs = words.map(word => (word, 1))

    // 4. 在每个单词实例计数为1的基础之上统计每个单词在文件中出现的总次数, 即key相同的value相加
    val wordscount: RDD[(String,Int)] = pairs.reduceByKey(_ + _)
    //  val wordscount = pairs.reduceByKey((v1, v2) => v1 + v2)  // 等同于

    // 5. 打印结果,使用collect会将集群中的数据收集到当前运行drive的机器上,需要保证单台机器能放得下所有数据
    wordscount.collect.foreach(println)

    // TODO 关闭连接
    sc.stop()

  }
}
运行