说明
本文介绍 通过 flink TABLE API 和 SQL 中的 connector,从 kafka 接收数据,处理后,写入到 kafka
官方:
https://ci.apache.org/projects/flink/flink-docs-release-1.12/dev/table/connectors/kafka.html
注意
向kafka放入数据时,由于kafka 只支持 append 方式,所以使用 table sql 时,不能执行 聚合函数
指定格式为 json 时,一定要事先做清洗,防止数据格式不正确,导致错误
执行流程
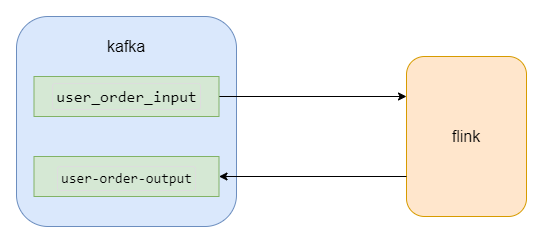
- flink 从 kafka的
user-order-output主题读取数据 - 执行查询
- flink 将查询结果写入到 kafka
user_order_input主题
pom.xml 依赖
需要添加下面依赖
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-connector-kafka_2.12</artifactId>
    <version>${flink.version}</version>
</dependency>
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-json</artifactId>
    <version>${flink.version}</version>
</dependency>
完整依赖
<properties>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    <maven.compiler.source>1.8</maven.compiler.source>
    <maven.compiler.target>1.8</maven.compiler.target>
    <flink.version>1.12.0</flink.version>
</properties>
<dependencies>
    <!--java-->
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-java</artifactId>
    <version>${flink.version}</version>
<!--    <scope>provided</scope>-->
</dependency>
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-streaming-java_2.12</artifactId>
    <version>${flink.version}</version>
<!--    <scope>provided</scope>-->
</dependency>
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-clients_2.12</artifactId>
    <version>${flink.version}</version>
<!--    <scope>provided</scope>-->
</dependency>
<dependency>
    <groupId>org.slf4j</groupId>
    <artifactId>slf4j-api</artifactId>
    <version>1.7.30</version>
<!--    <scope>provided</scope>-->
</dependency>
<dependency>
    <groupId>org.slf4j</groupId>
    <artifactId>slf4j-log4j12</artifactId>
    <version>1.7.30</version>
<!--    <scope>provided</scope>-->
</dependency>
<dependency>
    <groupId>log4j</groupId>
    <artifactId>log4j</artifactId>
    <version>1.2.17</version>
<!--    <scope>provided</scope>-->
</dependency>
    <!-- kafka Dependency -->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-connector-kafka_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-json</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <!--  table api、sql需要的依赖  -->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-table-planner-blink_2.12</artifactId>
        <version>${flink.version}</version>
<!--        <scope>provided</scope>-->
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-connector-files</artifactId>
        <version>${flink.version}</version>
    </dependency>
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-runtime-web_2.12</artifactId>
    <version>${flink.version}</version>
<!--    <scope>provided</scope>-->
</dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-connector-jdbc_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>mysql</groupId>
        <artifactId>mysql-connector-java</artifactId>
        <version>5.1.47</version>
    </dependency>
<!--  用的是 scala2.11,所以不能打包  -->
    <!--<dependency>-->
    <!--    <groupId>org.apache.bahir</groupId>-->
    <!--    <artifactId>flink-connector-redis_2.11</artifactId>-->
    <!--    <version>1.0</version>-->
    <!--</dependency>-->

    <dependency>
        <groupId>redis.clients</groupId>
        <artifactId>jedis</artifactId>
        <version>2.9.0</version>
    </dependency>
</dependencies>
java
package sql;

import org.apache.flink.api.common.RuntimeExecutionMode;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.EnvironmentSettings;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.TableResult;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import org.apache.flink.types.Row;

public class SQLKafka {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setRuntimeMode(RuntimeExecutionMode.AUTOMATIC);//自动模式,根据数据源自行判断
        //构建Table环境
        EnvironmentSettings bsSettings = EnvironmentSettings.newInstance().useBlinkPlanner().inStreamingMode().build();
        StreamTableEnvironment stEnv = StreamTableEnvironment.create(env, bsSettings);
        /*
        直接连接 kafka
        注意不要出现关键字,如:order等
         */
        TableResult table=stEnv.executeSql("CREATE TABLE t_order_input ( \n" +
                "  name STRING, \n" +
                "  price double, \n" +
                "  username STRING \n" +
                ") WITH (  \n" +
                "'connector' = 'kafka', \n"+//表示连接kafka
                "'topic' = 'user-order-input', \n"+//主题
                "'properties.bootstrap.servers' = 'hadoop1:9092,hadoop2:9092,hadoop3:9092', \n"+//服务器
                "'properties.group.id' = 'testGroup', \n"+//组
//                "'scan.startup.mode' = 'earliest-offset', "+//从最早位置消费
                "'scan.startup.mode' = 'latest-offset', \n"+//从最新位置消费
                "'format' = 'json' \n"+
                ")");
        /*
        创建结果表
         */
        TableResult sinkTable=stEnv.executeSql("CREATE TABLE t_order_output ( \n" +
                "  name STRING, \n" +
                "  price double \n" +
                ") WITH (  \n" +
                "'connector' = 'kafka', \n"+//表示连接kafka
                "'topic' = 'user-order-output', \n"+//主题
                "'properties.bootstrap.servers' = 'hadoop1:9092,hadoop2:9092,hadoop3:9092', \n"+//服务器
                "'properties.group.id' = 'testGroup', \n"+//组
//                "'scan.startup.mode' = 'earliest-offset', "+//从最早位置消费
                "'format' = 'json', \n"+
                "'sink.partitioner' = 'round-robin' \n"+//轮询分区
                ")");
        //执行查询。kafka只能写入append的数据,所以不能支持 聚合函数
        Table res=stEnv.sqlQuery("select name,price from t_order_input where price>60");
        // 用下面代码也可行
        // DataStream<Tuple2<Boolean, Row>> dsRes = stEnv.toRetractStream(res, Row.class);
        System.out.println("Schema信息:");
        //打印Schema
        res.printSchema();
        DataStream<Row> dsRes = stEnv.toAppendStream(res, Row.class);
        dsRes.print();
        stEnv.executeSql("insert into t_order_output select * from "+res);
        env.execute();
    }
}
注意: zookeeper 的主题名称不要有 . 或 _,详见 链接
启动 kafka 环境
启动 hadoop1、hadoop2、hadoop3
启动zookeeper
登录 hadoop1,执行下面命令
/program/bin/zk.sh start
启动kafka
登录 hadoop1,执行下面命令
/program/bin/kafka.sh start
准备 kafka 主题
创建主题 user_order_input
flink 从该主题 读取 数据:
/program/kafka_2.12-2.4.1/bin/kafka-topics.sh --create --zookeeper hadoop1:2181 --replication-factor 2 --partitions 3 --topic user-order-input
注意: zookeeper 的主题名称不要有 . 或 _,详见 链接
创建主题 user-order-output
flink 将 结果 发送 到该主题:
/program/kafka_2.12-2.4.1/bin/kafka-topics.sh --create --zookeeper hadoop1:2181 --replication-factor 2 --partitions 3 --topic user-order-output
启动 user-order-output 主题消费者
启动另一个窗口执行下面命令:
/program/kafka_2.12-2.4.1/bin/kafka-console-consumer.sh --bootstrap-server hadoop1:9092 --topic user-order-output
用于查看数据
测试
启动 java 程序
通过 idea 启动 flink程序
启动生产者 user-order-input,发送数据
启动另一个窗口执行下面命令:
/program/kafka_2.12-2.4.1/bin/kafka-console-producer.sh --broker-list hadoop1:9092 --topic user-order-input
在上面的环境中,输入下面内容,发送数据(可一条一条发,也可多条发):
{"name":"java从入门到精通","price":50,"username":"李雷"}
{"name":"spark从入门到精通","price":80,"username":"李雷"}
{"name":"hadoop从入门到精通","price":90,"username":"韩梅梅"}
{"name":"flink从入门到精通","price":70,"username":"韩梅梅"}
{"name":"mysql从入门到精通","price":100,"username":"李雷"}
{"name":"hive从入门到精通","price":100,"username":"lucy"}
{"name":"html从入门到精通","price":120,"username":"lucy"}
观察结果
idea控制台输出结果如下:
Schema信息:
root
 |-- name: STRING
 |-- price: DOUBLE

2> (true,spark从入门到精通,80.0)
1> (true,hadoop从入门到精通,90.0)
2> (true,flink从入门到精通,70.0)
user-order-output消费者窗口
输出下面内容
{"name":"hive从入门到精通","price":100.0}